
Содержание
- SSE4.2
- Изменения
- Новые инструкции SSE4.1
- СЫГРАЛ 20 МАТЧЕЙ ПОДРЯД НА SOURCE 2 — ЧТО ПРОИСХОДИТ В МАТЧМЕЙКИНГЕ CS 2
- Новые инструкции SSE4.2
- Процессоры с SSE4
- Литература
- Процессорные инструкции.
- Как Удалить Вирус Майнер || trayit || cpuminer || cpuminer-sse2.exe trayit как удалить
- SSE4.1 это расширенный набор команд SSE4 от Intel.
- Проверка поддержки 3DNow! процессором.
- Sse2 что это
- Особенности
- Регистры
- SSE-команды
- Пример
- См. также
- Ссылки
Выбор каждого 32/64-битного поля результата осуществляется зависимо от знака того же поля в неявном аргументе xmm0: или из первого, или из второго аргумента.
SSE4.2
SSE4 это новый набор команд Intel Core микроархитектуры, в первый раз реализованный в микропроцессорах серии Penryn (не следует путать с SSE4A от AMD). Он был анонсирован 27 Сентября 2006, но детализированное описание стало доступно только весной 2007, свежее описание для программистов можно отыскать тут на веб-сайте Intel.
SSE4 состоит из 54 инструкций, 47 из их относят к SSE4.1 (они есть исключительно в микропроцессорах Penryn). Полный набор команд (SSE4.1 и SSE4.2, другими словами 47 + оставшиеся 7 команд) доступен в микропроцессорах Intel с микроархитектурой Nehalem, которые были выпущены посреди ноября 2008 года. Ни одна из SSE4 инструкций не работает с 64-х битными mmx регистрами (только с 128-ми битными xmm0-15).
Компилятор языка Си от Intel начиная с версии 10 генерирует аннотации SSE4 при задании функции -QxS.
Изменения
Добавлены аннотации, ускоряющие компенсацию движения в видеокодеках, резвое чтение из WC памяти, огромное количество инструкций для упрощения векторизации программ компиляторами. Не считая того, в SSE4.2 добавлены аннотации обработки строк 8/16 битных знаков, вычисления CRC32, popcnt. В первый раз в SSE4 регистр xmm0 стал употребляться как неявный аргумент для неких инструкций.
Новые инструкции SSE4.1
Ускорение видео
Вычисление восьми сумм абсолютных значений разностей (SAD) смещённых 4-х байтных беззнаковых групп. Размещение операндов для 16-ти битных SAD определяется 3-мя битами конкретного аргумента imm8.
s1 = imm8[2]*4 s2 = imm8[1:0]*4 SAD0 = |A(s1+0)-B(s2+0)| + |A(s1+1)-B(s2+1)| + |A(s1+2)-B(s2+2)| + |A(s1+3)-B(s2+3)| SAD1 = |A(s1+1)-B(s2+0)| + |A(s1+2)-B(s2+1)| + |A(s1+3)-B(s2+2)| + |A(s1+4)-B(s2+3)| SAD2 = |A(s1+2)-B(s2+0)| + |A(s1+3)-B(s2+1)| + |A(s1+4)-B(s2+2)| + |A(s1+5)-B(s2+3)| . SAD7 = |A(s1+7)-B(s2+0)| + |A(s1+8)-B(s2+1)| + |A(s1+9)-B(s2+2)| + |A(s1+10)-B(s2+3)|
- PHMINPOSUW xmm1, xmm2/m128 — (Packed Horizontal Word Minimum)
- Input — < A0, A1,… A7 >
- Output —
Поиск посреди 16-ти битных беззнаковых полей A0…A7 такового, который имеет малое значение (и позицию с наименьшим номером, если таких полей несколько). Ворачивается 16-ти битное значение и его позиция.
- PMOV xmm1, xmm2/m — (Packed Move with Sign/Zero Extend)
Группа из 12-ти инструкций для расширения формата упакованных полей. Упакованные 8, 16, либо 32-х битные поля из младшей части аргумента расширяются (со знаком либо без) в 16, 32 либо 64-х битные поля результата.
+-------------------------------------------------------+ | Входной формат: | | +-----------------------------+ Результирующий формат: | | 8 бит | 16 бит | 32 бита | | +-----------------------------+-------------------------+ | PMOVSXBW | | | PMOVZXBW | 16 бит | +-----------------------------+-------------------------+ | PMOVSXBD PMOVSXWD | | | PMOVZXBD PMOVZXWD | 32 бита | +-----------------------------+-------------------------+ | PMOVSXBD PMOVSXWD PMOVSXWQ | | | PMOVZXBD PMOVZXWD PMOVZXWQ | 64 бита | +-----------------------------+-------------------------+
Векторные примитивы
- P xmm1, xmm2/m128 — (Minimum/Maximum of Packed Signed/Unsigned Byte/Word/DWord Integers)
Каждое поле результата есть малое/наибольшее значение соответственных полей 2-ух аргументов. Байтовые поля рассматриваются только как числа со знаком, 16-ти битные — только как числа без знака. Для 32-х битных упакованных полей предусмотрен вариант как со знаком, так и без.
Перемножение 32-х битных полей со знаком с выдачей полных 64-х бит результата (две операции умножения над 0 и 2 полями аргументов).
Перемножение 32-х битных полей со знаком с выдачей младших 32-х бит результатов (четыре операции умножения над всеми полями аргументов).
- PACKUSDW xmm1, xmm2/m128 — (Pack with Unsigned Saturation)
Упаковка 32-х битных полей со знаком в 16-ти битные поля без знака с насыщением.
- PCMPEQQ xmm1, xmm2/m128 — (Compare Packed Qword Data for Equal)
Проверка 64-х битных полей на равенство и выдача 64-х битных масок.
Вставки/извлечения
- INSERTPS xmm1, xmm2/m32, imm8 — (Insert Packed Single Precision Floating-Point Value)
Вставка 32-х битного поля из xmm2 (может быть избрать хоть какой из 4 полей этого регистра) либо из 32-х битной ячейки памяти в случайное поле результата. Не считая того, для каждого из полей результата можно задать сброс его в +0.0.
- EXTRACTPS r/m32, xmm, imm8 — (Extract Packed Single Precision Floating-Point Value)
Извлечение 32-х битного поля из xmm регистра, номер поля указывается в младших 2 битах imm8. Если в качестве результата указан 64-х битный регистр, то его старшие 32 бита сбрасываются (расширение без знака).
- PINSR xmm, r/m*, imm8 — (Insert Byte/Dword/Qword)
Вставка 8, 32, либо 64-х битного значения в обозначенное поле xmm регистра (другие поля не меняются).
- PEXTR r/m*, xmm, imm8 — (Extract Byte/Word/Dword/Qword)
Извлечение 8, 16, 32, 64 битного поля из обозначенного в imm8 поля xmm регистра. Если в качестве результата указан регистр, то его старшая часть сбрасывается (расширение без знака).
СЫГРАЛ 20 МАТЧЕЙ ПОДРЯД НА SOURCE 2 — ЧТО ПРОИСХОДИТ В МАТЧМЕЙКИНГЕ CS 2
Скалярное умножение векторов
- DPPS xmm1, xmm2/m128, imm8 — (Dot Product of Packed Single Precision Floating-Point Values)
- DPPD xmm1, xmm2/m128, imm8 — (Dot Product of Packed Double Precision Floating-Point Values)
Скалярное умножение векторов (dot product) 32/64 битных полей. Средством битовой маски в imm8 указывается, какие произведения полей должны суммироваться и что следует прописать в каждое поле результата: сумму обозначенных произведений либо +0.0.
Смешивания
- BLENDV xmm1, xmm2/m128, — (Variable Blend Packed Single/Double Precision Floating-Point Values)
Выбор каждого 32/64-битного поля результата осуществляется зависимо от знака того же поля в неявном аргументе xmm0: или из первого, или из второго аргумента.
- BLEND xmm1, xmm2/m128, imm8 — (Blend Packed Single/Double Precision Floating-Point Values)
Битовая маска (4 либо 2 бита) в imm8 показывает из какого аргумента следует взять каждое 32/64-битное поле результата.
- PBLENDVB xmm1, xmm2/m128, — (Variable Blend Packed Bytes)
Выбор каждого байтового поля результата осуществляется зависимо от знака б того же поля в неявном аргументе xmm0: или из первого, или из второго аргумента.
- PBLENDW xmm1, xmm2/m128, imm8 — (Blend Packed Words)
Битовая маска (8 бит) в imm8 показывает из какого аргумента следует взять каждое 16-битное поле результата.
Проверки бит
- PTEST xmm1, xmm2/m128 — (Logical Compare)
Установить флаг ZF, если исключительно в xmm2/m128 все биты помеченные маской из xmm1 равны нулю. Если все не помеченные биты равны нулю, то установить флаг CF. Другие флаги (AF, OF, PF, SF) всегда сбрасываются. Аннотация не видоизменит xmm1.
Округления
- ROUND xmm1, xmm2/m128, imm8 — (Round Packed Single/Double Precision Floating-Point Values)
Округление всех 32/64-х битных полей. Режим округления (4 варианта) выбирается или из MXCSR.RC, или задаётся конкретно в imm8. Также можно подавить генерацию исключения утраты точности.
- ROUND xmm1, xmm2/m128, imm8 — (Round Scalar Single/Double Precision Floating-Point Values)
Округление только младшего 32/64-х битного поля (другие биты остаются постоянными).
Чтение WC памяти
- MOVNTDQA xmm1, m128 — (Load Double Quadword Non-Temporal Aligned Hint)
Операция чтения, позволяющая ускорить (до 7.5 раз) работу с write-combining областями памяти.
Новые инструкции SSE4.2
Обработка строк
Эти аннотации делают арифметические сопоставления меж всеми вероятными парами полей (64 либо 256 сравнений!) из обоих строк, данных содержимым xmm1 и xmm2/m128. Потом булевые результаты сравнений обрабатываются для получения подходящих результатов. Конкретный аргумент imm8 управляет размером (байтовые либо unicode строчки, до 16/8 частей любая), знаковостью полей (частей строк), типом сопоставления и интерпретацией результатов.
Ими можно создавать в строке (области памяти) поиск знаков из данного набора либо в данных диапазонах. Можно сравнивать строки (области памяти) или производить поиск подстрок.
Они все влияют на флаги процессора: SF устанавливается если в xmm1 не полная строка, ZF — если в xmm2/m128 не полная строка, CF — если результат не нулевой, OF — если младший бит результата не нулевой. Флаги AF и PF сбрасываются.
Явное задание размера строк в , (берётся абсолютная величина регистров с насыщение до 8/16, зависимо от размера элементов строк. Результат в регистре ecx.
Явное задание размера строк в , (берётся абсолютная величина регистров с насыщение до 8/16, зависимо от размера элементов строк. Результат в регистре xmm0.
- PCMPISTRI, xmm1, xmm2/m128, imm8 — ()
Неявное задание размера строк (производится поиск нулевых элементов к каждой из строк). Результат в регистре ecx.
- PCMPISTRM, xmm1, xmm2/m128, imm8 — ()
Неявное задание размера строк (производится поиск нулевых элементов к каждой из строк). Результат в регистре xmm0.
Подсчет CRC32
- CRC32 r32, r/m* — (Подсчет CRC32)
Накопление значения CRC-32C (другие обозначения CRC-32/ISCSI CRC-32/CASTAGNOLI) для 8, 16, 32 или 64 битного аргумента (используется полином 0x11EDC6F41).
Подсчет популяции единичных бит
- POPCNT r, r/m* — (Return the Count of Number of Bits Set to 1)
Подсчет числа единичных бит. Три варианта инструкции: для 16, 32 и 64-х битных регистров. Также присутствует в SSE4A от AMD.
Векторные примитивы
- PCMPGTQ xmm1, xmm2/m128 — (Compare Packed Qword Data for Greater Than)
Проверка 64-х битных полей на «больше чем» и выдача 64-х битных масок.
Процессоры с SSE4
- Семейство Penryn процессоров Wolfdale, Yorkfield и поболее новые)
Литература
- iXBT.com 28 Сентября, 2006 IDF Fall`06: Intel готовит SSE4 в 2007-м
- iXBT.com 29 Марта, 2007 Презентация Intel Penryn (первое упоминание о Super Shuffle Engine)
- Описание SSE4 для программистов
Наборы расширения базовых инструкций процессоров SSE | SSE3 | SSE4 | 3DNow! | 3DNowExt Wikimedia Foundation . 2010 .
- SSG
- SSH File Transfer Protocol
Процессорные инструкции.
В современных процессорах инструкции используются для ускорения работы и оптимизации исполняемых алгоритмов. 3DNow! — AMD64 (x86-64) — EM64T (x86-64) — Extended 3DNow! — IA-32 (x86-32) — MIMD — MISD — MMX — SIMD — SISD — SSE — SSE2 — SSE3 — SSE4 — SSE4.1 — SSE4.2 — SSE4A — SSSE3
MMX (Multimedia Extensions — мультимедийное расширение) — коммерческое название дополнительного набора инструкций, выполняющих характерные для процессов кодирования/декодирования потоковых аудио/видео данных действия за одну машинную инструкцию. Впервые появился в процессорах Pentium MMX. Разработан в лаборатории Intel в Хайфе, Израиль, в первой половине 1990-х. SIMD (англ. Single Instruction, Multiple Data) — принцип компьютерных вычислений, позволяющий обеспечить параллелизм на уровне данных. SSE (англ. Streaming SIMD Extensions, потоковое SIMD-расширение процессора) — это SIMD (англ. Single Instruction, Multiple Data, Одна инструкция — множество данных) набор инструкций, разработанный Intel, и впервые представленный в процессорах серии Pentium III как ответ на аналогичный набор инструкций 3DNow! от AMD, который был представлен годом раньше. Первоначально названием этих инструкций было KNI что расшифровывалось как Katmai New Instructions (Katmai — название первой версии ядра процессора Pentium III). Технология SSE позволяла преодолеть 2 основных проблемы MMX — при использовании MMX невозможно было одновременно использовать инструкции сопроцессора, потому что его регистры использовались для MMX и работы с вещественными числами.
Как Удалить Вирус Майнер || trayit || cpuminer || cpuminer-sse2.exe trayit как удалить
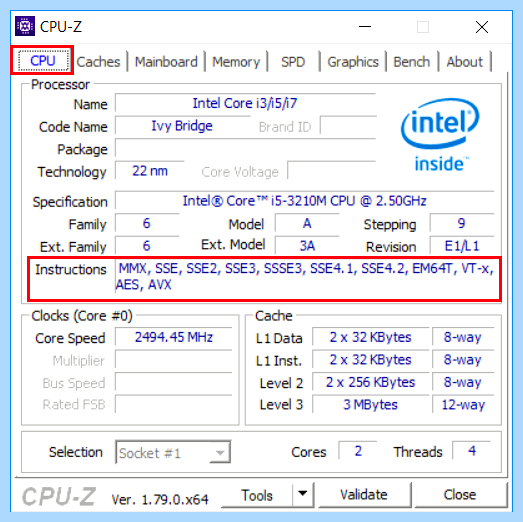
SSE включает в архитектуру процессора восемь 128-битных регистров (xmm0 до xmm7), любой из которых трактуется как 4 последовательных значения с плавающей точкой одинарной точности. SSE содержит в себе набор инструкций, который производит операции со скалярными и упакованными типами данных. Преимущество в производительности достигается в этом случае, когда необходимо произвести одну и ту же последовательность действий над разными данными. Реализация блоков SIMD осуществляется распараллеливанием вычислительного процесса между данными. Другими словами когда через один блок проходит поочерёдно множество потоков данных. SSE2 SSE2 (англ. Streaming SIMD Extensions 2, потоковое SIMD-расширение процессора) — это SIMD (англ. Single Instruction, Multiple Data, Одна инструкция — множество данных) набор инструкций, разработанный Intel, и впервые представленный в процессорах серии Pentium 4.
SSE2 использует восемь 128-битных регистров (xmm0 до xmm7), включённых в архитектуру x86 с вводом расширения SSE, любой из которых трактуется как 2 последовательных значения с плавающей точкой двойной точности. SSE2 содержит в себе набор инструкций, который производит операции со скалярными и упакованными типами данных. Также SSE2 содержит инструкции для потоковой обработки целочисленных данных в тех же 128- битных xmm регистрах, что делает это расширение более предпочтительным для целочисленных вычислений, нежели использование набора инструкций MMX, появившегося гораздо раньше. Преимущество в производительности достигается в этом случае, когда необходимо произвести одну и ту же последовательность действий над большим набором однотипных данных.
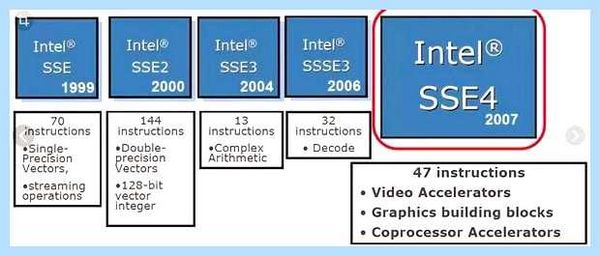
SSE3 (PNI — Prescott New Instruction) — третья версия SIMD-расширения Intel, потомок SSE, SSE2 и x87. Впервые представлено 2 февраля 2004 года в ядре Prescott процессора Pentium 4. В 2005 AMD предложила свою реализацию SSE3 для процессоров Athlon 64 (ядра Venice и San Diego). Набор SSE3 содержит 13 инструкций: — FISTTP (x87) — MOVSLDUP (SSE) — MOVSHDUP (SSE) — MOVDDUP (SSE2) — LDDQU (SSE/SSE2) — ADDSUBPD (SSE) — ADDSUBPD (SSE2) — HADDPS (SSE) — HSUBPS (SSE) — HADDPD (SSE2) — HSUBPD (SSE2) — MONITOR (нет аналога в SSE3 для AMD) — MWAIT (нет аналога в SSE3 для AMD).
SSE4 это набор команд Intel Core микроархитектуры, впервые реализованный в процессорах серии Penryn (не следует путать с SSE4A от AMD). Он был анонсирован 27 Сентября 2006, однако детальное описание стало доступно только весной 2007. SSE4 состоит из 54 инструкций, 47 из них относят к SSE4.1 (они есть исключительно в процессорах Penryn). Ожидается, что полный набор команд (SSE4.1 и SSE4.2, другими словами 47 + оставшиеся 7 команд) будет доступен в процессорах Nehalem. Ни одна из SSE4 инструкций не работает с 64-х битными mmx регистрами (только с 128-ми битными xmm0-15). Компилятор языка Си от Intel начиная с версии 10 генерирует инструкции SSE4 при задании опции -QxS. В SSE4 добавлены инструкции, ускоряющие компенсацию движения в видеокодеках, быстрое чтение из WC памяти, множество инструкций для упрощения векторизации программ компиляторами. Впервые в SSE4 регистр xmm0 стал использоваться как неявный аргумент для некоторых инструкций.
SSE4.1 это расширенный набор команд SSE4 от Intel.
Ниже приведены инструкции, входящие в SSE4.1: — Ускорение видео (3 инструкции) — Векторные примитивы (5 инструкций) — Вставки/извлечения (4 инструкции) — Скалярное умножение векторов (2 инструкции) — Смешивания (4 инструкции) — Проверки бит — Округления (2 инструкции) — Чтение WC памяти SSE4.2 состоит из 7 инструкций. — Обработка строк (4 инструкции) — Подсчет CRC32 — Подсчет популяции единичных бит — Векторные примитивы SSE4A это расширенный набор команд SSE4 от AMD, разработанный скорее не как дополнение, как альтернатива инструкциям SSE4 от Intel.
SSSE3 (Supplemental Streaming SIMD Extension 3) — это обозначение данное Intel 4-му расширению системы команд. Предыдущее имело обозначение SSE3 и Intel добавил ещё один символ ‘S’ вместо того, чтобы увеличить номер расширения, возможно так как они посчитали SSSE3 простым дополнением к SSE3. Часто, до того как стало использоваться официальное обозначение SSSE3, эти новые команды назывались SSE4. Также их называли кодовыми именами Tejas New Instructions (TNI) и Merom New Instructions (MNI) по названию процессоров, где впервые Intel намеревалась поддержать эти новые команды. Появившись в Intel Core Microarchitecture, SSSE3 доступно в сериях процессоров Xeon 5100 (Server и Workstation версии), также в процессорах Intel Core 2 (Notebook и Desktop версии). Новыми в SSSE3, по сравнению с SSE3, являются 16 уникальных команд, работающих с упакованными целыми. Каждая из них может работать как с 64-х битными (MMX), так и с 128-ми битными (XMM) регистрами, поэтому Intel в своих материалах ссылается на 32 новые команды. Вот некоторые из них: — Работа со знаком (2 инструкции) — Сдвиги — Перемешивание байт — Умножения (2 инструкции) — Горизонтальные сложения/вычитания целых (4 инструкции)
3DNow! — дополнительное расширение MMX для процессоров AMD, начиная с AMD K6 3D. Причиной создания 3DNow! послужило стремление завоевать превосходство над процессорами производства компании Intel в области обработки мультимедийных данных. Хотя это расширение является разработкой AMD, его также интегрировали в свои процессоры IBM, Cyrix и другие. Технология 3DNow! ввела 21 новую команду процессора и возможность оперировать 32-битными вещественными типами в стандартных MMX- регистрах. Также были добавлены специальные инструкции, оптимизирующие переключение в режим MMX/3DNow! (femms, которая заменяла стандартную инструкцию emms) и работу с кешем процессора. Таким макаром технология 3DNow! расширяла возможности технологии MMX, не требуя введения новых режимов работы процессора и новых регистров. В 3DNow! компания AMD добавила новый тип данных — 32-битные вещественные числа, инструкции для работы с этим типом, также некоторые инструкции для манипулирования стандартными типами MMX.
Проверка поддержки 3DNow! процессором.
До работы с расширением 3DNow! следует убедиться, что ЦП их поддерживает. Для этого используется инструкция CPUID. Общий порядок действий при проверке выглядит следующим образом: 1. Убедиться, что процессор поддерживает инструкцию CPUID. Если нет, то ЦП не поддерживает и 3DNow!. 2. Выполнить инструкцию cpuid со значением EAX = 0 — это необходимо для следующего шага. 3. Выполнить CPUID со значением EAX = 80000000h. Если после выполнения инструкции в EAX будет значение меньше 1, то 3DNow! не поддерживается. 4. Выполнить CPUID с EAX = 80000001h. Если после выполнения бит 31 регистра EDX будет установлен в 1, то 3DNow! поддерживается. Иначе — нет.
Sse2 что это
SSE (англ. Streaming SIMD Extensions , потоковое SIMD-расширение процессора) — это SIMD (англ. Single Instruction, Multiple Data , Одна инструкция — множество данных) набор инструкций, разработанный Intel и впервые представленный в процессорах серии Pentium III как ответ на аналогичный набор инструкций 3DNow! от AMD, который был представлен годом раньше. Первоначально названием этих инструкций было KNI — Katmai New Instructions (Katmai — название первой версии ядра процессора Pentium III).
Технология SSE позволяла преодолеть 2 основные проблемы MMX — при использовании MMX невозможно было одновременно использовать инструкции сопроцессора, потому что его регистры были общими с регистрами MMX, и возможность MMX работать только с целыми числами.
SSE включает в архитектуру процессора восемь 128-битных регистров и набор инструкций, работающих со скалярными и упакованными типами данных.
Преимущество в производительности достигается в этом случае, когда необходимо произвести одну и ту же последовательность действий над разными данными. В таком случае блоком SSE осуществляется распараллеливание вычислительного процесса между данными.
Особенности
- 8 (в x86-64 — 16)128-битных регистров XMM.
- 32-битный (в x86-64 — 64) регистр флагов (MXCSR).
- 128-битный упакованный тип данных с плавающей точкой одинарной точности.
- Инструкции над вещественными числами одинарной точности.
- Инструкции явной предвыборки данных, контроля кэширования данных и контроля порядка операций сохранения.
Регистры
В SSE добавлены восемь (шестнадцать) 128-битных регистров, которые называются xmm0 — xmm7 (-xmm15).
Каждый регистр может содержать четыре 32-битных значения с плавающей точкой одинарной точности.
SSE-команды
Команды для чисел с плавающей точкой
- Команды пересылки
- Скалярные типы – MOVSS
- Упакованные типы – MOVAPS, MOVUPS, MOVLPS, MOVHPS, MOVLHPS, MOVHLPS
- Скалярные типы – ADDSS, SUBSS, MULSS, DIVSS, RCPSS, SQRTSS, MAXSS, MINSS, RSQRTSS
- Упакованные типы – ADDPS, SUBPS, MULPS, DIVPS, RCPPS, SQRTPS, MAXPS, MINPS, RSQRTPS
- Скалярные типы – CMPSS, COMISS, UCOMISS
- Упакованные типы – CMPPS
- Упакованные типы – SHUFPS, UNPCKHPS, UNPCKLPS
- Скалярные типы – CVTSI2SS, CVTSS2SI, CVTTSS2SI
- Упакованные типы – CVTPI2PS, CVTPS2PI, CVTTPS2PI
- Упакованные типы – ANDPS, ORPS, XORPS, ANDNPS
Команды для целых чисел
- Арифметические команды
- PMULHUW, PSADBW, PAVGB, PAVGW, PMAXUB, PMINUB, PMAXSW, PMINSW
- PEXTRW, PINSRW
- PMOVMSKB, PSHUFW
Другие команды
- Работа с регистром MXCSR
- LDMXCSR, STMXCSR
- MOVNTQ, MOVNTPS, MASKMOVQ, PREFETCH0, PREFETCH1, PREFETCH2, PREFETCHNTA, SFENCE
Пример
Следующий пример демонстрирует перемножение четырёх пар чисел с плавающей точкой одной инструкцией mulps: (Программа написана на языке ANSI C++ с использованием ассемблерной вставки __asm и инструкций ассемблера для работы с SSE, аргументы записаны согласно стандарту Intel, а не AT&T)
float a[4] = 300.0, 4.0, 4.0, 12.0 >; float b[4] = 1.5, 2.5, 3.5, 4.5 >; __asm movups xmm0, a ; // поместить 4 переменные с плавающей точкой из a в регистр xmm0 movups xmm1, b ; // поместить 4 переменные с плавающей точкой из b в регистр xmm1 mulps xmm1, xmm0 ; // перемножить пакеты плавающих точек: xmm1 = xmm1 * xmm0 ; // xmm10 = xmm10 * xmm00 ; // xmm11 = xmm11 * xmm01 ; // xmm12 = xmm12 * xmm02 ; // xmm13 = xmm13 * xmm03 movups a, xmm1 ; // выгрузить результаты из регистра xmm1 по адресам a >;
Тот же пример, но ассемблерная вставка asm выполнена в стандарте AT&T (GNU Assembler)
float a[4] = 300.0, 4.0, 4.0, 12.0 >; float b[4] = 1.5, 2.5, 3.5, 4.5 >; __asm__ volatile ( "movups %[a], %%xmm0\n\t" // поместить 4 переменные с плавающей точкой из a в регистр xmm0 "mulps %[b], %%xmm0\n\t" // перемножить пакеты плавающих точек: xmm0 = xmm0 * b // xmm00 = xmm00 * b[0] // xmm01 = xmm01 * b[1] // xmm02 = xmm02 * b[2] // xmm03 = xmm03 * b[3] "movups %%xmm0, %[a]\n\t" // выгрузить результаты из регистра xmm1 по адресам a : : [a]"m"(*a), [b]"m"(*b) : "%xmm0", "%xmm1" );
См. также
Ссылки
- Корпорация Intel
- Официальное руководство по процессорам Intel, часть 2а Список инструкций, включаяя SSE, (A-M по лат. алфавиту) приведен в п. 3.2.
- Официальное руководство по процессорам Intel, часть 2b Список инструкций, включаяя SSE, (N-Z по лат. алфавиту) приведен в п. 4.2.
Наборы расширения базовых инструкций процессоров семейства x86 MMX | MMXEXT | SSE | SSE2 | SSE3 | SSSE3 | SSE4 | ATA | 3DNow! | 3DNowExt | SSE5 | AVX | AES - Инструкции x86
- Расширения архитектуры x86
Wikimedia Foundation . 2010 .
Похожие статьи
-
Содержание Популярно об MMX, SSE и AVX Ну о-о-очень первые дни V – значит «векторный». А MMX что значит? Проще пареной SSE Технологии и инструкции…
-
Содержание Включаем SSE2 Instructions в компьютере Данная функция обычно находится на вкладке: «SSE Tweaks» дальше «AMD Athlon MP» или «SSE Control»…